Jack N @ GitHub

Full stack AI Engineer, focus on: React, Next.js, node.js and .Net

问题

最近访问GitHub总是不稳定,经常连不上, 出各种错误(OpenSSL SSL_read: Connection was reset, errno 10054, Connection refused …)。

原因大概是GitHub的IP经常变化(一天可能变几次),我们本地的DNS解析有问题,解决办法就是查询github的IP,手工写到我们的hosts文件中。

查询GitHub最新IP

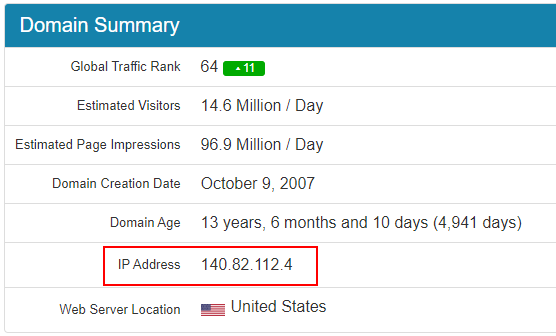
  1. 访问 https://github.com.ipaddress.com/
  2. IP Address 即为IP地址
    github ip

修改hosts文件

  1. 目录:C:\Windows\System32\drivers\etc
  2. 打开 hosts文件
  3. 结尾增加一行 140.82.112.4 github.com (IP 用你查询到的最新的IP)
  4. 搞定,测试一下

说明,hosts文件, 可以给github.com添加多条IP记录,这样当我们访问github时,会一次尝试每个IP是否可以访问,如果都不行,会去Internet上做DNS解析。
可以这样配置

1
2
3
4
140.82.112.4	github.com
140.82.113.4 github.com
140.82.112.3 github.com
140.82.114.4 github.com

https://jackniu81.github.io/2021/04/18/Algorithm-Fibonacci-numbers/

1. 斐波那契数列

斐波那契数列:0, 1, 1, 2, 3, 5, 8, 13 … …

通常用 F(n) 表示,形成的序列称为 斐波那契数列 。该数列由 0 和 1 开始,后面的每一项数字都是前面两项数字的和。

1
2
F(0) = 0F(1) = 1
F(n) = F(n - 1) + F(n - 2),其中 n > 1

敏捷开发时,我们估算Story Point,通常就是使用斐波那契数列。

2. 解题思路

2.1. 递归

F(n) = F(n - 1) + F(n - 2), 很简单,就不谈了。

2.2. 动态规划

动态规划的思想是,记录中间计算结果,计算后面相时,根据前面保存的结果直接计算,避免重复计算。

3. Javascript 实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
/**
* @param {number} n
* @return {number}
*/
var fib = function(n) {
if(n===0)
return 0;
if(n===1)
return 1;

let arr = [0,1]
for(let i=2;i<=n;i++){
arr[i] = arr[i-1] + arr[i-2];
}
return arr[n];
};

还可以进一步优化,当前使用数组记录以及计算过的F(n),由于F(n) = F(n - 1) + F(n - 2),实际只需要记录最近的2个值即可,不需要使用数组记录全部数据。

1. NET/dotnet core/.NET framework 的关系?

先看 2 张图
最新的.NET 5 的示意图
.NET 5
之前的(dotnet core3.x 时代)的示意图
dotnet core .3.1
总结如下:

  1. 2016 年开始,分开了.NET Framework 和.NET Core,后者开源、面向跨平台应用;
  2. 2019 年,.NET Framework 和.NET Core 被.NET5 完成了统一。未来只会有一个.NET,可以支持 Windows、Linux、macOS、iOS、Android、tvOS、watchOS 和 WebAssembly,等等
  3. .Net standard library 是之前.NET Framework 和.NET Core 公共的部分;

2. corefx, coreclr 都是什么?

dotnet 组织包含了.NET Core 的核心代码, 包括 coreclr 和 corefx 等.

  1. coreclr 是运行时代码,
  2. corefx 是各种基础类库的代码. CoreFX 主要包含数个公共库,例如 System.Collections, System.IO, System.Xml 等。

3. asp.net core

3.1. Kestrel

Kestrel 是 asp.net core 引入的跨平台的网络服务器,是默认配置。可以没有 iis, apache 和 nginx 就可以单独运行。
Kestrel 基于 libuv 实现;(node.js 也是基于 libuv)

3.2. asp.net core 主要的特性

  1. 依赖注入。
  2. 日志系统架构。
  3. 引入了一个跨平台的网络服务器,kestrel。可以没有 iis, apache 和 nginx 就可以单独运行。
  4. 可以使用命令行创建应用。
  5. 使用 AppSettings.json 来配置工程。
  6. 使用 start up 来注册服务。
  7. 更好的支持异步编程。
  8. 支持 web socket 和 signal IR。
  9. 对于跨网站的请求的预防和保护机制。

3.3. startup class 的作用?

Startup class 是 dot net core 应用的入口。所有的 dot net core 应用必须有这个 class。这个类用来配置应用。这个类的调用是在 program main 函数里面进行配置的。类的名字可以自己定义。

3.4. Startup class 的 config service 方法有什么作用?

在这个方法里我们可以添加一些 service 进入依赖注入容器。

3.5. startup class 的 configure 方法有什么作用?

这个方法来定义整个应用如何响应 HTTP 请求。它有几个比较重要的参数,application builder,Hosting environment, logo factory, 在这里我们可以配置一些中间件用来处理路径,验证和 session 等等。

3.6. 什么是 meta packages?

Meta packages 是指包含所有 ASP dot net code 依赖的一个包。叫做 Microsoft.AspNetCore.All

3.7. 什么是中间件?

中间件在这里是指注入到应用中处理请求和响应的组件。asp.net core 的中间件模型也是洋葱模型(和 node.js d Koa 一样)

3.8. application builder 的 use 和 run 方法有什么区别?

这两个方法都在 start up class 的 configure 方法里面调用。都是用来向应用请求管道里面添加中间件的。Use 方法可以调用下一个中间件的添加,而 run 不会。

3.9. dot net core 管道(pipeline)里面的 map 拓展有什么作用?

可以针对不同的路径添加不同的中间件。

1
2
3
4
5
public void Configure(IApplicationBuilder app)
{
app.Map("/path1", Middleware1);
app.Map("/path2", Middleware2);
}

3.10. 如何在 dot net core 中激活 session 功能?

  1. 首先要添加 session 包.
  2. 其次要在 config service 方法里面添加 session。
  3. 然后又在 configure 方法里面调用 usesession。

3.11. 如何在 controller 中注入 service?

依赖注入的思想:

  1. 在 config services 方法中配置这个 service。
  2. 在 controller 的构造函数中,添加这个依赖注入。

3.12. dot net core 里面的路径是如何处理的?

路径处理是用来为进入的请求寻找处理函数的机制。所有的路径在函数运行开始时进行注册。

主要有两种路径处理方式:

  1. 常规路径处理就是用 MapRoute 的方式设定调用路径
  2. 属性路径处理是指在调用函数的上方设定一个路径属性。

3.13. application builder 的 use 和 run 方法有什么区别?

这两个方法都在 start up class 的 configure 方法里面调用。都是用来向应用请求管道里面添加中间件的。Use 方法可以调用下一个中间件的添加,而 run 不会。

3.14. 依赖注入后的服务生命周期?

在 dot net core 中,我们不需要关心如何释放这些服务, 因为系统会帮我们释放掉。有三种服务的生命周期。

  1. 单实例服务, 通过 add singleton 方法来添加。在注册时即创建服务, 在随后的请求中都使用这一个服务。
  2. 短暂服务, 通过 add transient 方法来添加。是一种轻量级的服务,用于无状态服务的操作。
  3. 作用域服务,一个新的请求会创建一个服务实例。使用 add scoped 方法来添加。

3.15. 什么么是 Razor 页面?

是 dot net core 中支持 ASP 网页表格的一种开发模型。@page 作为页面的起始标志。可以看做是 asp.net core 使用的模板引擎。

3.16. 如何在 Razor 页面中实现数据模型绑定?

使用 bindproperty 属性。

3.17. Server.Transfer 和 Response.Redirect 的区别是什么

  1. Server.Transfer 仅是服务器中控制权的转向,在客户端浏览器地址栏中不会显示出转向后的地址;
  2. Response.Redirect 则是完全的跳转,浏览器将会得到跳转的地址,并重新发送请求链接。这样,从浏览器的地址栏中可以看到跳转后的链接地址。

3.18. API,什么时候用 Get/Post/Put/Delete

  1. GET: 查询
  2. POST :创建对象
  3. PUT: 修改对象
  4. DELETE:删除

4. C#

4.1. 一个单例(Singleton)类

单线程下的简单实现:

1
2
3
4
5
public MySingleton
{
private MySingleton(){} // 禁止被实例化
public readonly static MySingletonInstance = new MySingleton(); // 程序加载时就会初始化
}

线程安全的加锁双检查

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
public class MySingleton
{
private static MySingleton _instance = null;
private static readonly object SynObject = new object();

MySingleton() { }

public static MySingleton Instance
{
get
{
if (null == _instance)
{
lock (SynObject)
{
if (null == _instance)
{
_instance = new MySingleton();
}
}
}
return _instance;
}
}
}

4.2. abstract class 和 interface 有什么区别?

相同点:都不能被直接实例化,都可以通过继承实现其抽象方法。

不同点:

  1. 接口支持多继承;抽象类不能实现多继承。
  2. 接口只能定义行为;抽象类既可以定义行为,还可能提供实现。
  3. 接口只包含方法(Method)、属性(Property)、索引器(Index)、事件(Event)的签名,但不能定义字段和包含实现的方法;
  4. 抽象类可以定义字段、属性、包含有实现的方法。

4.3. 是否可以继承 String 类?

String 类是 sealed 类故不可以继承。

4.4. StringBuilder 和 String 的区别?

String 在进行运算时(如赋值、拼接等)会产生一个新的实例,而 StringBuilder 则不会。所以在大量字符串拼接或频繁对某一字符串进行操作时最好使用 StringBuilder,不要使用 String。
但是简单的字符拼接,String 还是首选。(100?次以内用 String,以上用 StringBuilder)

4.5. 什么情况下会用到虚方法?它与接口有什么不同?

  1. 子类重新定义父类的某一个方法时,必须把父类的方法定义为 virtual
  2. 在定义接口中不能有方法体,虚方法可以。
  3. 实现时,子类可以不重新定义虚方法,但如果一个类继承接口,那必须实现这个接口。

4.6. string、String;int、Int32;Boolean、bool 的区别

String、Int32、Boolean 等都属于.Net 中定义的类,而 string、int、bool 相当于 C#中对这些类定义的别名。CTS。

4.7. private、 protected、 public、 internal 修饰符的访问权限。

  1. private : 私有成员, 在类的内部才可以访问。
  2. protected : 保护成员,该类内部和继承类中可以访问。
  3. public : 公共成员,完全公开,没有访问限制。
  4. internal: 当前程序集内可以访问。

4.8. C#中的委托是什么?事件是不是一种委托?事件和委托的关系。

委托可以把一个方法作为参数代入另一个方法,可以理解为指向一个函数的指针。
换个说法来解释,委托就是函数指针,事件就是保存多个函数指针的数组。

事件和委托的区别如下:

  1. 事件只能在方法的外部进行声明,而委在方法的外部和内部都可以声明。
  2. 事件只能在类的内部触发,不能在类的外部触发。而委托在类的内部和外都都可以触发。
  3. 委托一般用于回调,而事件用于外部接口。例如在观察者模式中,在被观察者中可以声明一个事件作为外部观察者注册的接口。

4.9. override 与重载(overload)的区别

  1. 重载是方法的名称相同。参数或参数类型不同,进行多次重载以适应不同的需要。重载(overload)是面向过程的概念。
  2. Override 是进行基类中函数的重写。Override 是面向对象的概念

4.10. 什么是装箱(boxing)和拆箱(unboxing)

装箱:从值类型接口转换到引用类型。
拆箱:从引用类型转换到值类型。

——–END——–

参考:
https://www.webtrainingroom.com/interview/asp-net-core-interview-questions-answers > https://www.talkingdotnet.com/asp-net-core-interview-questions/

—————- END —————-

1. 基本问题

1.1. Vue.js 的特点

  • 易用: 简单,易学,上手快
  • 灵活: (渐进式)不断繁荣的生态系统,可以在一个库和一套完整框架之间自如伸缩。
  • 高效: 20kB min+gzip 运行大小;超快虚拟 DOM;最省心的优化
  • 双向绑定:开发效率高
  • 基于组件的代码共享
  • Web项目工程化,增加可读性、可维护性

1.2. Vue.js 双向绑定的原理

Vue.js 2.0 采用数据劫持(Proxy 模式)结合发布者-订阅者模式(PubSub 模式)的方式,通过 Object.defineProperty()来劫持各个属性的 setter,getter,在数据变动时发布消息给订阅者,触发相应的监听回调。

每个组件实例都有相应的watcher程序实例,它会在组件渲染的过程中把属性记录为依赖,之后当依赖项的setter被调用时,会通知watcher重新计算,从而致使它关联的组件得以更新。

Vue.js 3.0, 放弃了Object.defineProperty ,使用更快的ES6原生 Proxy (访问对象拦截器, 也称代理器)

步骤:

  1. 需要observe的数据对象进行递归遍历,包括子属性对象的属性,都加上setter和getter这样的话,给这个对象的某个值赋值,就会触发setter,那么就能监听到了数据变化

  2. compile解析模板指令,将模板中的变量替换成数据,然后初始化渲染页面视图,并将每个指令对应的节点绑定更新函数,添加监听数据的订阅者,一旦数据有变动,收到通知,更新视图

  3. Watcher订阅者是Observer和Compile之间通信的桥梁,主要做的事情是: ①在自身实例化时往属性订阅器(dep)里面添加自己 ②自身必须有一个update()方法 ③待属性变动dep.notice()通知时,能调用自身的update()方法,并触发Compile中绑定的回调,则功成身退。

  4. MVVM作为数据绑定的入口,整合Observer、Compile和Watcher三者,通过Observer来监听自己的model数据变化,通过Compile来解析编译模板指令,最终利用Watcher搭起Observer和Compile之间的通信桥梁,达到数据变化 -> 视图更新;视图交互变化(input) -> 数据model变更的双向绑定效果。

1.3. Vue.js 3.0 放弃defineProperty, 使用Proxy的原因

Object.defineProperty缺陷

  1. 监控到数组下标的变化时,开销很大。所以Vue.js放弃了下标变化的检测;
  2. Object.defineProperty只能劫持对象的属性,而Proxy是直接代理对象。Object.defineProperty需要遍历对象的每个属性,如果属性值也是对象,则需要深度遍历。而 Proxy 直接代理对象,不需要遍历操作。
  3. Object.defineProperty对新增属性需要手动进行Observe。vue2时需要使用 vm.$set 才能保证新增的属性也是响应式
  4. Proxy支持13种拦截操作,这是defineProperty所不具有的
  5. Proxy 作为新标准,长远来看,JS引擎会继续优化 Proxy,但 getter 和 setter 基本不会再有针对性优化

1.4. Vue 2 中给 data 中的对象属性添加一个新的属性时会发生什么?如何解决?

视图并未刷新。这是因为在Vue实例创建时,新属性并未声明,因此就没有被Vue转换为响应式的属性,自然就不会触发视图的更新,这时就需要使用Vue的全局 api $set():this.$set(this.obj, 'new_property', 'new_value')

1.5. Computed和Watch的区别

  1. computed 计算属性 : 依赖其它属性值,并且 computed 的值有缓存,只有它依赖的 属性值发生改变,下一次获取 computed 的值时才会重新计算 computed 的值。
  2. watch 侦听器 : 更多的是观察的作用,无缓存性,类似于某些数据的监听回调,每 当监听的数据变化时都会执行回调进行后续操作。

运用场景:

  1. 当我们需要进行数值计算,并且依赖于其它数据时,应该使用 computed,因为可以利用 computed 的缓存特性,避免每次获取值时,都要重新计算。
  2. 当我们需要在数据变化时执行异步或开销较大的操作时,应该使用 watch,使用 watch 选项允许我们执行异步操作 ( 访问一个 API ),限制我们执行该操作的频率, 并在我们得到最终结果前,设置中间状态。这些都是计算属性无法做到的。
  3. 多个因素影响一个显示,用Computed;一个因素的变化影响多个其他因素、显示,用Watch;

1.6. Computed 和 Methods 的区别

  1. computed: 计算属性是基于它们的依赖进行缓存的,只有在它的相关依赖发生改变时才会重新求值对于 method ,只要发生重新渲染,
  2. method 调用总会执行该函数

1.7. 虚拟DOM,diff算法

(1)让我们不用直接操作DOM元素,只操作数据便可以重新渲染页面
(2)虚拟dom是为了解决浏览器性能问题而被设计出来的
当操作数据时,将改变的dom元素缓存起来,都计算完后再通过比较映射到真实的dom树上
(3)diff算法比较新旧虚拟dom。如果节点类型相同,则比较数据,修改数据;如果节点不同,直接干掉节点及所有子节点,插入新的节点;如果给每个节点都设置了唯一的key,就可以准确的找到需要改变的内容,否则就会出现修改一个地方导致其他地方都改变的情况。比如A-B-C-D, 我要插入新节点A-B-M-C-D,实际上改变的了C和D。但是设置了key,就可以准确的找到B C并插入

1.8. 为何需要Virtual DOM?

  1. 具备跨平台的优势
  2. 操作 DOM 慢,js运行效率高。我们可以将DOM对比操作放在JS层,提高效率。
  3. 提升渲染性能

1.9. 过滤器 (Filter)

在Vue中使用filters来过滤(格式化)数据,filters不会修改数据,而是过滤(格式化)数据,改变用户看到的输出(计算属性 computed ,方法 methods 都是通过修改数据来处理数据格式的输出显示。
使用场景: 比如需要处理时间、数字等的的显示格式;

1.10. 常见的事件修饰符及其作用

  1. .stop:等同于 JavaScript 中的 event.stopPropagation() ,防止事件冒泡;
  2. .prevent :等同于 JavaScript 中的 event.preventDefault() ,防止执行预设的行为(如果事件可取消,则取消该事件,而不停止事件的进一步传播);
  3. .capture :当元素发生冒泡时,先触发带有该修饰符的元素。若有多个该修饰符,则由外而内触发。如 div1中嵌套div2中嵌套div3.capture中嵌套div4,那么执行顺序为:div3=》div4=》div2=》div1
  4. .self :只会触发自己范围内的事件,不包含子元素;
  5. .once :只会触发一次。

1.11. v-show指令和v-if指令的区别是什么?

v-show 仅仅控制元素的显示方式,将 display 属性在 block 和 none 来回切换;而v-if会控制这个 DOM 节点的存在与否。当我们需要经常切换某个元素的显示/隐藏时,使用v-show会更加节省性能上的开销;当只需要一次显示或隐藏时,使用v-if更加合理。

1.12. v-model 是如何实现的,语法糖实际是什么

  1. 作用在表单元素上v-model="message"等同于v-bind:value="message" v-on:input="message=$event.target.value"
  2. 作用在组件上, 本质是一个父子组件通信的语法糖,通过prop和$.emit实现, 等同于:value="message" @input=" $emit('input', $event.target.value)"

1.13. data为什么是一个函数而不是对象

JavaScript中的对象是引用类型的数据,当多个实例引用同一个对象时,只要一个实例对这个对象进行操作,其他实例中的数据也会发生变化。

而在Vue中,我们更多的是想要复用组件,那就需要每个组件都有自己的数据,这样组件之间才不会相互干扰。

所以组件的数据不能写成对象的形式,而是要写成函数的形式。数据以函数返回值的形式定义,这样当我们每次复用组件的时候,就会返回一个新的data,也就是说每个组件都有自己的私有数据空间,它们各自维护自己的数据,不会干扰其他组件的正常运行。

1.14. Vue template 到 render 的过程

  1. 调用parse方法将template转化为ast(抽象语法树, abstract syntax tree)
  2. 对静态节点做优化。如果为静态节点,他们生成的DOM永远不会改变,这对运行时模板更新起到了极大的优化作用。
  3. 生成渲染函数. 渲染的返回值是VNode,VNode是Vue的虚拟DOM节点,里面有(标签名,子节点,文本等等)

1.15. Vue data 中某一个属性的值发生改变后,视图会立即同步执行重新渲染吗?

不会立即同步执行重新渲染。
Vue 实现响应式并不是数据发生变化之后 DOM 立即变化,而是按一定的策略进行 DOM 的更新。
Vue 在更新 DOM 时是异步执行的。只要侦听到数据变化, Vue 将开启一个队列,并缓冲在同一事件循环中发生的所有数据变更。

如果同一个watcher被多次触发,只会被推入到队列中一次。这种在缓冲时去除重复数据对于避免不必要的计算和 DOM 操作是非常重要的。
然后,在下一个的事件循环”tick”中,Vue 刷新队列并执行实际(已去重的)工作。

1.16. axios是什么

易用、简洁且高效的http库, 支持node端和浏览器端,支持Promise,支持拦截器等高级配置。

1.17. sass是什么?如何在vue中安装和使用?

sass是一种CSS预编译语言安装和使用步骤如下。

  1. 用npm安装加载程序( sass-loader、 css-loader等加载程序)。
  2. 在 webpack.config.js中配置sass加载程序。

1.18. Vue.js页面闪烁

Vue. js提供了一个v-cloak指令,该指令一直保持在元素上,直到关联实例结束编译。当和CSS一起使用时,这个指令可以隐藏未编译的标签,直到实例编译结束。用法如下。

1
2
3
4
[v-cloak]{ 
 display:none;
}
<div v-cloak>{{ title }}</div>

1.19. 如何解决数据层级结构太深的问题

在开发业务时,经常会岀现异步获取数据的情况,有时数据层次比较深,如以下代码: span 'v-text="a.b.c.d"></span>, 可以使用vm.$set手动定义一层数据: vm.$set("demo",a.b.c.d)

1.20. 在 Vue. js开发环境下调用API接口,如何避免跨域

config/ index.js内对 proxyTable项配置代理。

1.21. 批量异步更新策略

Vue 在修改数据后,视图不会立刻更新,而是等同一事件循环中的所有数据变化完成之后,再统一进行视图更新。
换句话说,只要观察到数据变化,就会自动开启一个队列,并缓冲在同一个事件循环中发生的所以数据改变。在缓冲时会去除重复数据,从而避免不必要的计算和 DOM 操作。

1.22. vue 的 nextTick 方法的实现原理

  1. vue 用异步队列的方式来控制 DOM 更新和 nextTick 回调先后执行
  2. microtask 因为其高优先级特性,能确保队列中的微任务在一次事件循环前被执行完毕

1.23. Vue 组件 data 为什么必须是函数 ?

因为组件是可以复用的,JS 里对象是引用关系,如果组件 data 是一个对象,那么子组件中的 data 属性值会互相污染。
所以一个组件的 data 选项必须是一个函数,因此每个实例可以维护一份被返回对象的独立的拷贝。

1.24. v-if和v-for一起使用的弊端及解决办法

由于v-for的优先级比v-if高,所以导致每循环一次就会去v-if一次,而v-if是通过创建和销毁dom元素来控制元素的显示与隐藏,所以就会不停的去创建和销毁元素,造成页面卡顿,性能下降。

解决办法:

  1. 在v-for的外层或内层包裹一个元素来使用v-if
  2. 用computed处理

1.25. vue常用指令

  1. v-model 多用于表单元素实现双向数据绑定(同angular中的ng-model)
  2. v-bind 动态绑定 作用: 及时对页面的数据进行更改
  3. v-on:click 给标签绑定函数,可以缩写为@,例如绑定一个点击函数 函数必须写在methods里面
  4. v-for 格式: v-for=”字段名 in(of) 数组json” 循环数组或json(同angular中的ng-repeat)
  5. v-show 显示内容 (同angular中的ng-show)
  6. v-hide 隐藏内容(同angular中的ng-hide)
  7. v-if 显示与隐藏 (dom元素的删除添加 同angular中的ng-if 默认值为false)
  8. v-else-if 必须和v-if连用
  9. v-else 必须和v-if连用 不能单独使用 否则报错 模板编译错误
  10. v-text 解析文本
  11. v-html 解析html标签
  12. v-bind:class 三种绑定方法 1、对象型 ‘{red:isred}’ 2、三元型 ‘isred?”red”:”blue”‘ 3、数组型 ‘[{red:”isred”},{blue:”isblue”}]’
  13. v-once 进入页面时 只渲染一次 不在进行渲染
  14. v-cloak 防止闪烁
  15. v-pre 把标签内部的元素原位输出

1.26. 组件传值方式有哪些

  1. 父传子:子组件通过props[‘xx’] 来接收父组件传递的属性 xx 的值
  2. 子传父:子组件通过 this.$emit(‘fnName’,value) 来传递,父组件通过接收 fnName 事件方法来接收回调
  3. 其他方式:通过创建一个bus,进行传值
  4. 使用Vuex

1.27. vue-loader是什么?使用它的用途有哪些?

2. 组件 Component

2.1. vue中如何编写可复用的组件 (编写组件的原则)

  1. 以组件功能命名
  2. 只负责ui的展示和交互动画,不要在组件里与服务器打交道(获取异步数据等)
  3. 可复用组件不会因组件使用的位置、场景而变化。尽量减少对外部条件的依赖。

2.2. 如何让CSS只在当前组件中起作用?

在每一个Vue.js组件中都可以定义各自的CSS、 JavaScript代码。如果希望组件内写的CSS只对当前组件起作用,只需要在Style标签添加Scoped属性,即

2.3. keep-alive是什么?

如果需要在组件切换的时候,保存一些组件的状态防止多次渲染,就可以使用 keep-alive 组件包裹需要保存的组件。

两个重要属性,include 缓存组件名称,exclude 不需要缓存的组件名称。

2.4. 如何在 Vue. js动态插入图片

对“src”属性插值将导致404请求错误。应使用 v-bind:src (简写:src)格式代替。

2.5. 父子组件的生命周期顺序

  1. 加载渲染过程:
    父beforeCreate->父created->父beforeMount->子beforeCreate->子created->子beforeMount->子mounted->父mounted
  2. 子组件更新过程:父beforeUpdate->子beforeUpdate->子updated->父updated
  3. 父组件更新过程:父beforeUpdate->父updated
  4. 销毁过程:父beforeDestroy->子beforeDestroy->子destroyed->父destroyed

3. Vuex

3.1. vuex的核心概念

  1. state => 基本数据
  2. getters => 从基本数据派生的数据
  3. mutations => 修改数据,同步
  4. actions => 修改数据,异步 (Action 提交的是 mutation,而不是直接变更状态)
  5. modules => 模块化Vuex

3.2. vuex是什么?怎么使用?哪种功能场景使用它?

Vuex 是一个专为 Vue.js 应用程序开发的状态管理器,采用集中式存储管理应用的所有组件的状态,主要是为了多页面、多组件之间的通信。
Vuex有5个重要的属性,分别是 State、Getter、Mutation、Action、Module,由 view 层发起一个 Action 给 Mutation,在 Mutation 中修改状态,返回新的状态,通过 Getter暴露给 view层的组件或者页面,页面监测到状态改变于是更新页面。如果你的项目很简单,最好不要使用 Vuex,对于大型项目,Vuex 能够更好的帮助我们管理组件外部的状态,一般可以运用在购物车、登录状态、播放等场景中。

3.3. 多个组件之间如何拆分各自的state,每块小的组件有自己的状态,它们之间还有一些公共的状态需要维护,如何思考这块

  1. 公共的数据部分可以提升至和他们最近的父组件,由父组件派发
  2. 公共数据可以放到vuex中统一管理,各组件分别获取

4. Router

4.1. vue-router路由的两种模式

vue-router中默认使用的是hash模式

  1. hash模式, 带#。如:http://localhost:8080/#/pageA。改变hash,浏览器本身不会有任何请求服务器动作的,但是页面状态和url已经关联起来了。
  2. history模式,不带#, 如:http://localhost:8080/ 正常的而路径,并没有#。基于HTML5的 pushState、replaceState实现

4.2. vue-router如何定义嵌套路由

通过children 数组:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
const router = new VueRouter({
routes: [
{
path: "/parentPage",
component: testPage,
children: [
{
path: "/childrenA",
component: childrenComponentA,
},
{
path: "/childrenB",
component: childrenComponentB,
},
],
},
{
// 其他和parentPage平级的路由
},
],
});

4.3. vue-router有哪几种导航钩子?

  1. 全局导航钩子:router.beforeEach(to,from,next)
  2. 组件内的钩子beforeRouteEnter (to, from, next) beforeRouteUpdate (to, from, next) beforeRouteLeave (to, from, next)
  3. 单独路由独享组件 beforeEnter: (to, from, next)

4.4. $route和$router的区别

  1. $route是“路由信息对象”,包括path,params,hash,query,fullPath,matched,name等路由信息参数。
  2. $router是“路由实例”对象包括了路由的跳转方法,钩子函数等

4.5. 路由之间跳转的方式

  1. 声明式(标签跳转)
  2. 编程式( js跳转)

4.6. active-class是哪个组件的属性

vue-router 模块 的router-link组件

环境:

  • React 17.x
  • react-router-dom: 5.2

1. 概述

React 本身是一个极简的类库,并且遵循渐进式原则,所以是不带路由(Router)功能的。对于稍复杂些的应用,没有路由显然是不可以的,所以就需要引入路由(React Router)库。

React Router 从5.0开始只分为Core,Web 和Native3种。 从5.0开始,彻底将原本的针对网页使用的react-router的npm package命名改为了react-router-dom。也就是说,针对web应用,用react-router-dom吧。(本文暂不涉及Native)

官方文档: https://reacttraining.com/react-router/

BrowserRouter与HashRouter的区别

React Router 有2中模式,BrowserRouter与HashRouter,下面我们来看一下区别

  1. url表现形式不一样,看是否包含#
  1. 底层原理不一样
  • BrowserRouter使用的是HTML5的history API(window.history.pushState, popState)
  • HashRouter使用的是URL的哈希值。
  1. 刷新后对路由state参数的影响
  • BrowserRouter没有任何影响,因为state保存在history对象中。
  • HashRouter刷新后会导致路由state参数的丢失。

安装和使用

  1. 安装:
    npm i react-router-dom

  2. 简单使用,
    参考:https://reactrouter.com/web/guides/quick-start

环境:

  • Angular: 8+

1. 为什么要优化

双向绑定是一柄双刃剑,提高开发效率的同时,也牺牲了性能。当然,随着硬件性能的提升,Angular自身性能的提升,对于一般(中小)复杂度的应用,性能问题可以忽略不计。但是对于特殊场景,或复杂页面来说,我们就需要单独的处理数据绑定问题,否则就会有卡顿的现象,影响用户体验。

2. 编程习惯方面

平时的一些小技巧,小习惯,都可以改善Angular绑定方面的性能。

2.1. NgForOf,加入trackBy提升性能

trackBy定义如何跟踪可迭代项的更改的函数。在迭代器中添加、移动或删除条目时,指令必须重新渲染适当的 DOM 节点。为了最大程度地减少 DOM 中的搅动,仅重新渲染已更改的节点。

默认情况下,变更检测器假定对象实例标识可迭代对象。提供此函数后,指令将使用调用此函数的结果来标识项节点,而不是对象本身的标识。

2.2. Angular数据绑定的三种方式

1
2
3
4
5
<div>
<span>Name {{item.name}}</span> <!-- 1. 直接绑定 -->
<span>Classes {{item | classPipe}}</span><!-- 2. pipe方式-->
<span>Classes {{classes(item)}}</span><!-- 3.绑定方法调用的结果 -->
</div>
  1. 直接绑定: 大多数情况下,这都是性能最好的方式。
  2. 绑定方法调用的结果:在每个脏值检测过程中,classes方程都要被调用一遍。如果没有特殊需求,应尽量避免这种使用方式。
  3. pipe方式: 它和绑定function类似,每次脏值检测classPipe都会被调用。不过Angular给pipe做了优化,加了缓存,如果item和上次相等,则直接返回结果。
1
<li *ngFor="let item of items; index as i; trackBy: trackByFn">...</li>

2.3. 除非需要,都是用单向绑定,减少监控值的个数

对于一般数据来说,都是只需要展示给用户,不需要修改。那么对于这部分数据,使用单向绑定即可(ts->html).
如:

1
2
<!-- 也称插值绑定 -->
<span>{{yourMessage}}</span>

3. ChangeDetectionStrategy.OnPush 进行性能提升

对于一些很复杂的页面,上面的小技巧就不够用了,不过Angular也是考虑到这些了,提供了不少方法。
Angular 对比 AngularJS 在变化检测上由原来的双向检测(父->子,子->父)变为了单向(父->子)。所以每一次变化检测都会确定性地收敛。
Angular定义一个组件时,可以传入一个变化检测配置项为

1
changeDetection: ChangeDetectionStrategy.OnPush | ChangeDetectionStrategy.Default;

onpush策略只判断输入的引用(如果是object)是否改变,来判断是否进行脏检查。因此,我们可以使用onpush策略来减少变化检测的开销。

4. 利用ngzone-runOutsideAngular优化

Angular依赖NgZone来监听异步操作,并从根部执行变化检测。换句话说,我们代码中的每一个 addEventListener都会触发脏检查。但是如果我们非常明确,有些addEventListener要执行的东西,不会(或者说可以忽略)影响数据结果,不想然他触发脏检查。比如监测scroll,监测鼠标事件等。

针对这种情况, 我们可以使用zone提供的runOutsideAngular,让这些事件不触发脏检查。

1
2
3
this.zone.runOutsideAngular(() => {
window.document.addEventListener('mousemove', this.bindMouse);
});

5. 手动控制脏检查 ChangeDetectorRef

Angular的ChangeDetectorRef实例上提供了可以绑定或解绑某个组件脏检查的方法。

1
2
3
4
5
6
7
8
class ChangeDetectorRef {
markForCheck() : void // 通知框架进行变化检查/Change Detection
detach() : void // 禁止脏检查
detectChanges() : void // 手工触发脏检查, 从该组件到各个子组件执行一次变化检测
checkNoChanges() : void
reattach() : void // detach逆操作,启用脏检查
}

6. 总结

  1. 平时的一些小习惯,都可以提高angular的性能;
  2. 针对复杂应用,或者当出现卡顿时,我们也是有办法的!

CSS实现水平垂直居中

  1. margin: auto;实现绝对定位元素的居中
    .center-vertical{
        width: 100px;
        height: 100px;
        background: orange;
        position: absolute;
        top: 0;
        left: 0;
        right: 0;
        bottom: 0;
        margin: auto;
    }
  1. CSS3.0弹性布局
      html,
      body {
        width: 100%;
        height: 100%;
      }
      body {
        display: flex;
        align-items: center;
        justify-content: center; /* 定义body的元素水平居中 */
      }
      .content {
        width: 300px;
        height: 300px;
        background: orange;
      }

行内元素有哪些?块级元素有哪些?

  1. 行内元素有:a b span img input select strong
  2. 块级元素有:div ul ol li dl dt dd h1 h2 h3 h4…p
  3. 常见的空元素: <br> <hr> <img> <input> <link> <meta>

CSS3有哪些新特性?

  1. 新增各种CSS选择器 (: not(.input):)
  2. 圆角 (border-radius:8px)
  3. 多列布局 (multi-column layout)
  4. 阴影和反射 (Shadow\Reflect)
  5. 文字特效 (text-shadow)
  6. 文字渲染 (Text-decoration)
  7. 线性渐变 (gradient)
  8. 旋转 (transform)
  9. 缩放,定位,倾斜,动画,多背景


—————- END —————-


======================

前端(Fontend)面试题汇总

1. http 1.1/2.0 新增加的功能

HTTP1.1

  1. 缓存处理,在 HTTP1.0 中主要使用 header 来控制缓存策略。
  2. 带宽优化及网络连接的使用,HTTP1.1 则在请求头引入了 range 头域,它允许只请求资源的某个部分, 并且支持断点续传。
  3. 错误通知的管理,在 HTTP1.1 中新增了 24 个错误状态响应码,如 409(Conflict)表示请求的资源与资源的当前状态发生冲突;410(Gone)表示服务器上的某个资源被永久性的删除。
  4. Host 头处理,在 HTTP1.0 中认为每台服务器都绑定一个唯一的 IP 地址,因此,请求消息中的 URL 并没有传递主机名(hostname)。但随着虚拟主机技术的发展,在一台物理服务器上可以存在多个虚拟主机(Multi-homed Web Servers),并且它们共享一个 IP 地址。HTTP1.1 的请求消息和响应消息都应支持 Host 头域,且请求消息中如果没有 Host 头域会报告一个错误(400 Bad Request)。
  5. 长连接,HTTP 1.1 支持长连接(PersistentConnection)和请求的流水线(Pipelining)处理,在一个 TCP 连接上可以传送多个 HTTP 请求和响应. (Connection: keep-alive)

HTTP2.0 大幅度的提高了 web 性能,进一步减少了网络的延迟。实现低延迟高吞吐量。

  1. 二进制分帧 (二进制格式编码)
  2. 首部压缩 (header)
  3. 多路复用 (HTTP2.0 可以在共享 TCP 连接的基础上同时发送请求和响应,避免 HTTP 旧版本的队头阻塞问题)
  4. 请求优先级
  5. 服务器推送 (服务端根据客户端的请求,提前返回多个响应,推送额外的资源给客户端。)

2. 用户输入 URL 到浏览器显现给用户页面经过了什么过程

  1. 用户输入 URL,浏览器获取到 URL
  2. 检查缓存,如果有有效缓存,直接加载
  3. 浏览器(应用层)进行 DNS 解析(直接输入 IP 地址既跳过该步骤)
  4. 根据解析出的 IP 地址+端口,浏览器(应用层)发起 HTTP 请求
  5. 请求到达传输层,tcp 协议为传输报文提供可靠的字节流传输服务,它通过三次握手等手段来保证传输过程中的安全可靠。通过对大块数据的分割成一个个报文段的方式提供给大量数据的便携传输。
  6. 服务器端收到发送方的 HTTP 请求之后,进行请求文件资源(如 HTML 页面)的寻找并响应报文
  7. 客户端收到返回内容后,处理 html
  8. 解析 html,生成 dom 树
  9. CSS 解析,为 DOM 中元素加入样式
  10. javascript 解析处理,更改 dom 树
  11. 进行页面渲染
  12. 重排、重绘

3. HTML5 的新特性

  1. 新的内容标签:header nav content footer article 1. aside
  2. 更好的单元格体系:
  3. 音频、视频 API:video radio
  4. 画布(Canvas) API
  5. 地理(Geolocation) API
  6. 网页存储(Web storage) 1. API:localStorage,sessionStorage
  7. 拖拽释放(Drag and drop) API

4. 对浏览器内核的理解

主要分成两部分:渲染引擎(layout engine 或 Rendering Engine)和 JS 引擎。

  1. 渲染引擎:负责取得网页的内容(HTML、XML、图像等等)、整理讯息(例如加入 CSS 等),以及计算网页的显示方式,然后会输出至显示器或打印机。浏览器的内核的不同对于网页的语法解释会有不同,所以渲染的效果也不相同。所有网页浏览器、电子邮件客户端以及其它需要编辑、显示网络内容的应用程序都需要内核。
  2. JS 引擎则:解析和执行 javascript 来实现网页的动态效果。最开始渲染引擎和 JS 引擎并没有区分的很明确,后来 JS 引擎越来越独立,内核就倾向于只指渲染引擎。

5. cookies,sessionStorage 和 localStorage

cookie 是网站为了标示用户身份而储存在用户本地终端(Client Side)上的数据(通常经过加密)。
cookie 数据始终在同源的 http 请求中携带(即使不需要),记会在浏览器和服务器间来回传递。
sessionStorage 和 localStorage 不会自动把数据发给服务器,仅在本地保存。

存储大小:
cookie 数据大小不能超过 4k。
sessionStorage 和 localStorage 虽然也有存储大小的限制,但比 cookie 大得多,可以达到 5M 或更大。

有期时间:
localStorage 存储持久数据,浏览器关闭后数据不丢失除非主动删除数据;
sessionStorage 数据在当前浏览器窗口关闭后自动删除。
cookie 设置的 cookie 过期时间之前一直有效,即使窗口或浏览器关闭

6. 如何实现浏览器内多个标签页之间的通

WebSocket、SharedWorker;也可以调用 localstorge、cookies 等本地存储方式;

7. script标签中的async、defer属性的作用

  1. Async: 可选属性。表示应该立即下载脚本,但不应妨碍页面中的其他操作,比如下载其他资源或等待加载其他脚本。
  2. Defer: 可选属性。标识脚本可以延迟到文档完全被解析和显示之后再执行。

2021 javascript 面试题汇总

1. this 都可以是哪些内容

对 C#、Java 等语言,this 就是当前对象,但是 javascript 不是,简单来说:

  • 全局 this 是 window;
  • 函数 this 是调用者;
  • 构造函数的 this 是 new 之后的新对象,
  • call 和 apply bind 的 this 第一个参数

2. 原型链, prototype

  • 函数对象都包含 prototype 属性(函数的原型对象),其作用就是让该函数所实例化的对象们都可以找到公用的属性和方法;
  • constructor 属性的含义就是指向该对象的构造函数
  • __proto__和 constructor 属性是对象所独有的;prototype 属性是函数所独有的,因为函数也是一种对象,所以函数也拥有__proto__和 constructor 属性。
  • JavaScript 的每个对象都继承另一个父级对象,父级对象称为原型 (prototype) 对象。
  • 每一个实例对象都有一个私有属性proto指向其构造函数的原型对象 prototype;该原型对象也会作为实例对象有一个私有属性proto,层层向上直到一个对象的原型对象值为 null。
  • 当访问一个对象的属性或方法时,js 引擎会先查找该对象本身是否包含,如果没有,会去该对象的proto属性所指向的原型对象上找,如果没有,会继续向上一层找,直到某个对象的proto值为 null,这就是原型链。
  • 每个构造函数都有一个 prototype 属性,指向另外一个对象,说明整个对象所有的属性和方法都会被构造函数所拥有。

3. new 操作符都做了什么

new 运算符创建一个用户定义的对象类型的实例或具有构造函数的内置对象类型之一。

new Object()举例:

  1. 创建一个新对象
  2. 把新对象的原型(__proto__)指向构造函数的 prototype
  3. 把构造函数里的 this 指向新对象
  4. 返回这个新对象

4. Javascript 的内存回收机制

Javascript 内嵌了垃圾收集器,用来跟踪内存的分配和使用,以便当分配的内存不再使用时,自动释放它。垃圾收集器会按照固定的时间间隔,或代码执行中预定的收集时间,周期性地执行这一操作。
垃圾收集器必须跟踪哪个变量有用哪个变量无用,对于不再有用的变量打上标记,以备将来收回其所占用的内存。用于标识无用变量的策略通常有标记清除和引用计数两种。不同浏览器采用的策略不完全一致。

5. 内存泄漏的主要原因

  • 缓存
  • 队列消费不及时
  • 作用域未释放

6. Javascript 性能优化

  1. 针对 js 方面的前端性能优化,可以 1)使用 ansyc/defer 加载;2)加载时,放到</body>之前;3) 合并 JS 文件,并进行最小化处理;4)缓存;5)使用 CDN 网络;6)js 的 HTTP 压缩
  2. 删除未使用的功能性代码以及与之相关的代码, 多余的依赖库,被滥用的 npm 包。
  3. 减少作用域链上的查找次数(减少循环中的活动)。比如 for 循环,把 Array.length 赋值给一个变量,而不是每次比较都直接使用 length 属性;对页面元素进行操作时,取出复制给一个变量,每次操作都对这个变量进行操作,而不是每次操作都再重复取一下这个元素;
  4. 闭包导致的内存泄露。闭包可以保证函数内的变量安全,可以读取函数内部的变量,另一个就是让这些变量的值始终保持在内存中,不会被自动清除。我们需要手动销毁内存中的变量。(赋值为 null);
  5. 尽量少用全局变量,尽量使用局部变量。
  6. 减少不必要的变量
  7. 类型转换:把数字转换成字符串使用 number + “” 。 性能对比: (“” + ) > String() > .toString() > new String()
  8. 对字符串进行循环操作,譬如替换、查找,应使用正则表达式。因为本身 JavaScript 的循环速度就比较慢,而正则表达式的操作是用 C 写成的语言的 API,性能很好。
  9. 浮点数转换成整型使用 Math.floor()或者 Math.round()。parseInt()是用于将字符串转换成数字,Math 是内部对象,所以 Math.floor()其实并没有多少查询方法和调用的时间,速度是最快的。
  10. 使用 classname 代替大量的内联样式修改。
  11. 循环遍历,尽量少用 for in, 虽然代码易读,但性能很差。 尤其是遍历属性数量未知的情况下,少用。

7. ES6/ES7/ES8/… 新增的功能

7.1. ES6 (2015)

  • 模块化
  • 箭头函数
  • 函数参数默认值
  • 模板字符串
  • 解构赋值
  • 延展操作符
  • 对象属性简写
  • Promise
  • Let与Const

7.2. ES7(2016)

  • 数组includes()方法,用来判断一个数组是否包含一个指定的值,根据情况,如果包含则返回true,否则返回false。
  • **指数运算符: a ** b指数运算符,它与 Math.pow(a, b)相同。

7.3. ES8(2017)

  • async/await
  • Object.values()
  • Object.entries()
  • String padding: padStart()和padEnd(),填充字符串达到当前长度
  • 函数参数列表结尾允许逗号
  • Object.getOwnPropertyDescriptors()
  • ShareArrayBuffer和Atomics对象,用于从共享内存位置读取和写入

7.4. ES9(2018)

  • 异步迭代
  • Promise.finally()
  • Rest/Spread 属性: ES2015引入了Rest参数和扩展运算符。三个点(…)仅用于数组。Rest参数语法允许我们将一个不定数量的参数表示为一个数组。
  • 正则表达式命名捕获组
  • 正则表达式反向断言

7.5. ES10新特性(2019)

  • 行分隔符(U + 2028)和段分隔符(U + 2029)符号现在允许在字符串文字中,与JSON匹配
  • 更加友好的 JSON.stringify
  • 新增了Array的flat()方法和flatMap()方法
  • 新增了String的trimStart()方法和trimEnd()方法
  • Object.fromEntries()
  • Symbol.prototype.description
  • String.prototype.matchAll
  • Function.prototype.toString()现在返回精确字符,包括空格和注释
  • 简化try {} catch {},修改 catch 绑定
  • 新的基本数据类型BigInt
  • globalThis
  • import()
  • Legacy RegEx
  • 私有的实例方法和访问器

7.6. ES11(2020)

  • Nullish coalescing Operator(空值处理)
  • import() 按需导入

7.7. ES12(2021)

  • string增加replaceAll
  • Promise.any, 收一个Promise可迭代对象,只要其中的一个 promise 成功,就返回那个已经成功的 promise
  • WeakRefs, 使用WeakRefs的Class类创建对对象的弱引用(对对象的弱引用是指当该对象应该被GC回收时不会阻止GC的回收行为)
  • 数字分隔符
  • 逻辑运算符和赋值表达式

8. === VS ==

1
2
3
4
5
100 == "100"; // true
0 == ""; // true
0 == false; // true
false == ""; // true
null == undefined; // true

很有意思吧, 看看这两个,是等效的:

1
2
obj == null;
obj === null || obj === undefined;

9. 闭包

在 JavaScript 中,实现外部作用域访问内部作用域中变量的方法叫做闭包(closure)。这得益于高阶函数的特性:函数可以作为参数或者者返回值;

当一个内部函数被调用,就会形成闭包,闭包就是能够读取其他函数内部变量的函数,就是一个函数去访问了另外一个函数的中的变量的函数。

闭包作用:局部变量无法共享和长久的保存,而全局变量可能造成变量污染,所以我们希望有一种机制既可以长久的保存变量又不会造成全局污染。延伸变量的作用范围。

闭包特点:占用更多内存;不容易被释放

闭包用法:变量既想反复使用,又想避免全局污染如何使用?

  1. 定义外层函数,封装被保护的局部变量。
  2. 定义内层函数,执行对外部函数变量的操作。
  3. 外层函数返回内层函数的对象,并且外层函数被调用,结果保存在一个全局的变量中。

e.g.

1
2
3
4
5
6
7
function outerMethod() {
var a = "some value";
var innerMethod = function () {
console.log(a + "!");
};
innerMethod();
}

10. js 里的作用域是什么样子的?

大多数语言里边都是块作作用域,以{}进行限定,js 里边不是.js 里边叫函数作用域,就是一个变量在全函数里有效.比如有个变量 p1 在函数最后一行定义,第一行也有效,但是值是 undefined.

11. let 和 var 的区别

  • var 声明变量可以重复声明,而 let 不可以重复声明,属于 TDZ 暂时性死区问题
  • 作用域不同,var 是函数作用域,而 let 是块级作用域;
  • var 可以在声明的上面访问变量,而 let 不存在变量提升;

12. 对 async 和 await 的理解

  1. async…await 是基于 promise 的 generator 语法糖,是用来解决异步的,它用来等待 promise 的执行结果,常规函数使用 await 没有效果;
  2. async 函数返回一个 Promise 对象,可以使用 then 方法添加回调函数
  3. 当函数执行的时候,一旦遇到 await 就会先返回,等到异步操作完成,再接着执行函数体内后面的语句;

13. promised 的三种状态

promise 有三种状态:pending/reslove/reject 。pending 就是未决,resolve 可以理解为成功,reject 可以理解为拒绝。

14. async/await 的优点

1)方便级联调用: 即调用依次发生的场景;

2)同步代码编写方式: Promise 使用 then 函数进行链式调用,一直点点点,是一种从左向右的横向写法;async/await 从上到下,顺序执行,就像写同步代码一样,更符合代码编写习惯;

3)多个参数传递: Promise 的 then 函数只能传递一个参数,虽然可以通过包装成对象来传递多个参数,但是会导致传递冗余信息,频繁的解析又重新组合参数,比较麻烦;async/await 没有这个限制,可以当做普通的局部变量来处理,用 let 或者 const 定义的块级变量想怎么用就怎么用,想定义几个就定义几个,完全没有限制,也没有冗余工作;

4)同步代码和异步代码可以一起编写: 使用 Promise 的时候最好将同步代码和异步代码放在不同的 then 节点中,这样结构更加清晰;async/await 整个书写习惯都是同步的,不需要纠结同步和异步的区别,当然,异步过程需要包装成一个 Promise 对象放在 await 关键字后面;

5)基于协程: Promise 是根据函数式编程的范式,对异步过程进行了一层封装,async/await 基于协程的机制,是真正的“保存上下文,控制权切换……控制权恢复,取回上下文”这种机制,是对异步过程更精确的一种描述;

6)async/await 是对 Promise 的优化: async/await 是基于 Promise 的,是进一步的一种优化,不过在写代码时,Promise 本身的 API 出现得很少,很接近同步代码的写法;

15. async/await 的写法

1
2
3
4
5
6
7
8
9
async function testAsync() {
return "hello async";
}

// 调用时
async function test() {
var value = await testAsync();
console.log(value);
}

16. apply、call 和 bind 的区别

这三者都是用来改变函数的 this 对象的指向的(也就是说要改变函数运行时的 context 即上下文),第一个参数都是 this 要指向的对象。

不同之处:

  1. call 接受连续参数,apply 接受数组参数。
  2. bind 功能和 call apply 差不多,区别在于 bind 返回的是一个改变 this 指向的新函数,这个函数不是立即执行函数(call apply 两个立即执行!)

17. 深拷贝的原理

操作的是值,取出对象的值,放到一个新的{},修改时不会影响到原数据;要完成对象的深拷贝需要使用递归遍历所有对象的属性进行赋值,也可以使用 JSON.stringfy 和 JSON.parse 操作。

18. set 和 Map 的区别

  1. Set 是一种类似数组的集合类型,它与数组不同的是,不允许存在重复数据;常用操作方法有:add,delete,has,clear 等;遍历使用 forEach;
  2. Map 是一种类似对象的集合类型,它与对象不同的是,key 可以接受对象类型,常用的操作方法有:set,get,has,delete 等;遍历使用 forEach

19. JS 实现双向绑定 (vue/angular 双向绑定的原理)

vue.js 采用数据劫持(Proxy 模式)结合发布者-订阅者模式(PubSub 模式)的方式,通过 Object.defineProperty()来劫持各个属性的 setter,getter,在数据变动时发布消息给订阅者,触发相应的监听回调。
Object.defineProperty( )内还包含一对儿 getter 和 setter 函数,它们被称作这个对象的访问器属性,这两个函数都不是必须的,只是在读取访问对象属性时,会调用 getter 函数,这个函数负责返回有效值,在写入对象属性时,会调用 setter 函数并传入新值,这个函数负责决定如何处理数据。

Angular, 采用脏检查的方式。基于 zone.js,重写 setTimeout, httpRequest 等方法,触发脏检查, 更新 dom 节点。

20. var 和 let 的区别

  1. 作用域不同, var 是函数作用域,let 是块作用域。
  • 在函数中声明了 var,整个函数内都是有效的,比如说在 for 循环内定义的一个 var 变量,实际上其在 for 循环以外也是可以访问的
  • 而 let 由于是块作用域,所以如果在块作用域内定义的变量,比如说在 for 循环内,在其外面是不可被访问的,所以 for 循环推荐用 let
  1. let 不能在定义之前访问该变量,但是 var 可以。 (var 可以提升变量作用域)
  2. let不能被重新定义,但是var是可以的。(重新定义var,执行时会忽略)

21. Javascript 如何实现继承?

1、构造继承
2、原型继承: Child.prototype = new Parent();
3、实例继承
4、拷贝继承

22. 变量提升

js 引擎首先在读取 js 代码时默认执行 2 个步骤:

  1. 解释(通篇扫描所有 js 代码,然后把所有声明(变量申明、函数声明)提升到对应作用域顶端)
  2. 执行(执行逻辑操作)
1
2
3
4
5
6
7
8
// 例1.
console.log(b); // 输出 ReferenceError: b is not defined
b = 2;

// 例2.
console.log(b); // 输出 undefined
var b = 2;
console.log(b); // 输出 2

23. 函数提升

首先要知道函数定义有两种方式的,一种是函数定义表达式,一种是函数声明语句。

1
2
3
4
5
6
7
// 函数定义表达式
var f = function (){
};

// 函数声明语句
function f(){
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
// 提升测试
// 例1.
f();
function f() {
console.log("test");
}
//输出 test

// 例2.
f();
var f = function () {
console.log("test");
};

//输出 Uncaught TypeError: f is not a function

// 例3
console.log(f);
var f = 10;
console.log(f);
function f() {
console.log("fff");
}
// 输出
// [Function: f]
// 10
// 10

// 例4
var a = 1;
function foo() {
a = 10;
console.log(a); // 输出:10
return;
function a() {} // 看似无用, 实际上在foo的作用域内重新声明了'a',和外面的a不一样了
}
foo();
console.log(a); // 输出:1
//输出:
// 10
// 1

重点:

  1. 函数提升针对是函数声明语句而言,其次变量提升只提升变量名而函数提升会提升整个函数体
  2. 优先级,函数提升会在变量提升的上面

24. 作用域

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
// 例1 块级作用域, 不适合变量提升
// es6允许块级作用域的任意嵌套。外层作用域无法读取内层作用域的变量。
// 内层作用域可以定义外层作用域的同名变量。

var v = "hello";
if (true) {
console.log(v);
var v = "world";
}
//输出 hello

var v = "hello";
if (true) {
console.log(v);
var v = "world";
var z = "!";
}
console.log(v, z);
//输出 :
// hello
// world !

// 例2 闭包,变量提升
var v = "hello";
(function () {
console.log(v);
var v = "world";
})();
//输出 undefined

// 例 3, 块级作用域内let和const命令所声明的变量,只在命令所在的代码块内有效。
if (true) {
let a = 10;
var b = 1;
}
console.log(a); //ReferenceError: a is not defined.
console.log(b); // 1

// 例4 let, var与作用域、变量提升
if (true) {
console.log(a); //ReferenceError: a is not defined.
console.log(b); // 1

let a = 10;
var b = 1;
}
console.log(a); //ReferenceError: a is not defined.
console.log(b); // 1

25. 实现一个随机排序的程序

1
2
3
4
5
6
7
8
9
10
11
function randomSort() {
return Math.random() - 0.5;
}
let list = [1, 2, 3, 4, 5, 6, 7, 8, 9, 0];
list.sort(randomSort);
console.log("after random sort: ", list.join(","));

// ES6 箭头函数写法
let list = [1, 2, 3, 4, 5, 6, 7, 8, 9, 0];
list.sort(() => Math.random() - 0.5);
console.log("after random sort: ", list.join(","));

26. 实现一个函数,传入一个字符串,得到使用次数最多的字符,以及数量

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
function getMostUsedChar(sourceString) {
let length = sourceString.length;
let counter = {};
for (var i = 0; i < length; i++) {
let currentChar = sourceString[i];
if (counter[currentChar]) {
counter[currentChar]++;
} else {
counter[currentChar] = 1;
}
}

let maxCount = 0;
let maxChar = "";
for (const key in counter) {
if (counter[key] >= maxCount) {
maxChar = key;
maxCount = counter[key];
}
}

console.log(`most used char: ${maxChar}, count: ${maxCount}`);
}

getMostUsedChar("fjiwejfal33232jkj3fjfie");

参考:

1. nodejs 有哪些特点?

是单线程的,但是有很高的可扩展性,使用 JavaScript 作为主流编程语言。使用的是非阻塞IO,异步处理机制和事件驱动。处理高效。

擅长 IO 密集型业务业务处理,不擅长 CPU 密集型业务;

2. 什么是事件循环 Event Loop

在进程启动动时,Node 会创建一个类似于 while(true)的循环,每执行一次循环的过程我们称之为 Tick。每个 Tick 的过程就是查看是否有事件等待处理,如果有,就取出时间相关的回调函数。如果存在相关联的回调函数,就执行它们。然后进入下一个循环;如果不再有事件待处理,就退出进程。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
   ┌───────────────────────┐
┌─>│ timers │
│ └──────────┬────────────┘
│ ┌──────────┴────────────┐
│ │ I/O callbacks │
│ └──────────┬────────────┘
│ ┌──────────┴────────────┐
│ │ idle, prepare │
│ └──────────┬────────────┘ ┌───────────────┐
│ ┌──────────┴────────────┐ │ incoming: │
│ │ poll │<─────┤ connections, │
│ └──────────┬────────────┘ │ data, etc. │
│ ┌──────────┴────────────┐ └───────────────┘
│ │ check │
│ └──────────┬────────────┘
│ ┌──────────┴────────────┐
└──┤ close callbacks │
└───────────────────────┘
  1. timers: 这个阶段执行 setTimeout()和 setInterval()设定的回调。
  2. I/O callbacks: 执行几乎所有的回调,除了 close 回调,timer 的回调,和 setImmediate()的回调。
  3. idle, prepare: 仅内部使用。
  4. poll: 获取新的 I/O 事件;node 会在适当条件下阻塞在这里。
  5. check: 执行 setImmediate()设定的回调。
  6. close callbacks: 执行比如 socket.on(‘close’, …)的回调。

在底层, Node 是通过 libuv 来实现多线程的。Libuv库负责 Node API 的执行。它将不同的任务分配给不同的线程,形成一个事件循环, 以异步的方式将任务的执行结果返回给 V8 引擎。

另:浏览器下的 Event Loop 如下:

  1. 所有任务都在js执行线程上执行,形成一个执行栈(Execution Context Stack)
  2. 在js执行线程之外还存在一个任务队列(Task Queen),系统把异步任务放到任务队列中,然后主线程继续执行后续的任务
  3. 一旦执行栈中所有的任务执行完毕,系统就会读取任务队列。如果这时异步任务已结束等待状态,就会从任务队列进入执行栈,恢复执行
  4. js执行线程不断重复上面的第三步

3. 在每个 tick 的过程中,如何判断是否有事件需要处理呢?

  1. 每个事件循环中有一个或者多个观察者,而判断是否有事件需要处理的过程就是向这些观察者询问是否有要处理的事件。
  2. 在 Node 中,事件主要来源于网络请求、文件的 I/O 等,这些事件对应的观察者有文件 I/O 观察者,网络 I/O 的观察者。
  3. 事件循环是一个典型的生产者/消费者模型。异步 I/O,网络请求等则是事件的生产者,源源不断为 Node 提供不同类型的事件,这些事件被传递到对应的观察者那里,事件循环则从观察者那里取出事件并处理。

4. 什么是回调函数?

回调函数是指用一个函数作为参数传入另一个函数,这个函数会被在某个时机调用。

5. node.js 计时器 promise.then, process.nextTick, setTimeout,setImmediate 执行顺序

首先了解 2 个概念

  • macro-task(宏任务): script ,setTimeout, setInterval, setImmediate, I/O, UI rendering.Event Loop 在每个阶段执行的任务;
  • micro-task (微任务): process.nextTick, Promise,Object. fvEvent Loop 在每个阶段之间执行的任务 observe,MutationObserver

对于 node.js, micro-task 的任务优先级高于 macro-task 的任务优先级,所以微任务普遍优先于宏任务的执行。

另一种优先级顺序,是“观察者优先级”, 在每次轮训检查中,各观察者的优先级分别是:idle观察者 > I/O观察者 > check观察者。

  • idle 观察者:process.nextTick
  • I/O 观察者:一般性的 I/O 回调,如网络,文件,数据库 I/O 等
  • check 观察者:setTimeout > setImmediate (setTimeout(()=>{},0)优先于 setImmediate 执行);
  • 总结
  1. 同步代码执行顺序优先级高于异步代码执行顺序优先级;
  2. new Promise(fn)中的 fn 是同步执行;
  3. process.nextTick()>Promise.then()>setTimeout>setImmediate。

6. next tick 和 setImmediate 的区别是什么?

  • NextTick 会等待当前的 event 执行完成或者下一轮儿事件循环到达再执行。

  • SetImmediate, 会在下一轮的事件循环中,执行回调并且返回当前的循环来做读写操作.

7. node.js 模块加载机制

Nodejs 遵循 commonjs 规范的模块加载机制,使用 require 加载文件,使用 exports 或 module.exports 导出文件

8. 什么是 globals?

有三个 global 的关键字。

  1. Global 代表的是最上层的命名空间,用来管理所有其他的全局对象。
  2. Process 是一个全局对象,可以把异步函数转化成异步回调, 它可以在任何地方被访问,它主要是用来返回系统的应用信息和环境信息.
  3. Buffer, 是用来处理二进制数据的类.

9. 什么是 EventEmitter?

EventEmitter 是 node 中一个实现观察者模式的类,主要功能是监听和发射消息,用于处理多模块交互问题.

主要用于: 1) 模块间传递消息 2) 回调函数内外传递消息 3) 处理流数据,因为流是在 EventEmitter 基础上实现的. 4) 观察者模式发射触发机制相关应用

10. process 有哪些常用方法?

process.stdin, process.stdout, process.stderr, process.on, process.env, process.argv, process.arch, process.platform, process.exit

11. 解释一下什么是 reactor pattern。

reactor 设计模式是 event-driven architecture 的一种实现方式,处理多个客户端并发的向服务端请求服务的场景。每种服务在服务端可能由多个方法组成。reactor 会解耦并发请求的服务并分发给对应的事件处理器来处理。

Reactor pattern 主要是非阻滞的 i/o 操作。提供一个回调函数来关联 io 操作。io 请求完成以后会不会提交给 demultiplexer, 这是一个通知接口用来处理并发性的非阻滞的 io 操作,这个功能是通过查询一个 event loop 来实现的.

12. 什么是错误优先的回调函数

node.js 广泛使用异步编程,而异步中的异常很难在主程序中捕获。为此,我们将异步中的异常、错误,通过回调函数传递给主程序。

错误优先的回调函数用于传递错误和数据。第一个参数始终应该是一个错误对象, 用于检查程序是否发生了错误。其余的参数用于传递数据。

13. 如何避免回调地狱

  1. 模块化:将回调函数分割为独立的函数
  2. 使用 Promise/ansyc (ES6)
  3. 使用 yield 来计算生成器或 Promise

14. 什么是 Promise?

Promise 可以帮助我们更好地处理异步操作。采用类似同步结构的代码,实现异步处理,同时避免回调地狱。

15. 使用 NPM 有哪些好处?

通过 NPM,你可以安装和管理项目的依赖,并且能够指明依赖项的具体版本号。 对于 Node 应用开发而言,你可以通过 package.json 文件来管理项目信息,配置脚本, 以及指明项目依赖的具体版本。

16. 什么是 Stub?

Stub 是用于模拟一个组件或模块的函数或程序,在测试用例中很常用。简单的说,你可以用 Stub 去模拟一个方法,从而避免调用真实的方法, 使用 Stub 你还可以返回虚构的结果。你可以配合断言使用 Stub。

17. 什么是测试金字塔?

测试金字塔指的是: 测试用例从下到上,包括单元测试、集成测试、端到端测试;当我们在编写测试用例时,底层的单元测试应该远比上层的端到端测试要多。

18. Node 模块机制

Node 中,每个文件模块都是一个对象,所有的模块都是 Module 的实例。

19. Node.js require 的模块加载机制

1、先计算模块路径
2、如果模块在缓存里面,取出缓存;如果不存在生成模块实例,存入缓存
3、加载模块
4、输出模块的 exports 属性

20. V8 的垃圾回收机制

在 V8 中,主要将内存分为新生代和老生代两代。新生代中的对象存活时间较短的对象,老生代中的对象存活时间较长,或常驻内存的对象。
新生代中的对象主要通过 Scavenge 算法进行垃圾回收。这是一种采用复制的方式实现的垃圾回收算法。它将堆内存一份为二,分为 2 个 semispace。在这两个 semispace 空间中,只有一个处于使用中,另一个处于闲置状态。处于使用状态的 semispace 空间称为 From 空间,处于闲置状态的空间称为 To 空间。

  1. 当开始垃圾回收的时候,会检查 From 空间中的存活对象,这些存活对象将被复制到 To 空间中,而非存活对象占用的空间将会被释放。完成复制后,From 空间和 To 空间发生角色对换。
  2. 应为新生代中对象的生命周期比较短,就比较适合这个算法。
  3. 当一个对象经过多次复制依然存活,它将会被认为是生命周期较长的对象。这种新生代中生命周期较长的对象随后会被移到老生代中。
    老生代主要采取的是标记清除的垃圾回收算法。与 Scavenge 复制活着的对象不同,标记清除算法在标记阶段遍历堆中的所有对象,并标记活着的对象,只清理死亡对象。活对象在新生代中只占叫小部分,死对象在老生代中只占较小部分,这是为什么采用标记清除算法的原因。

标记清楚算法的问题
主要问题是每一次进行标记清除回收后,内存空间会出现不连续的状态

  1. 这种内存碎片会对后续内存分配造成问题,很可能出现需要分配一个大对象的情况,这时所有的碎片空间都无法完成此次分配,就会提前触发垃圾回收,而这次回收是不必要的。
  2. 为了解决碎片问题,标记整理被提出来。就是在对象被标记死亡后,在整理的过程中,将活着的对象往一端移动,移动完成后,直接清理掉边界外的内存。

21. child-process

node 是异步非阻塞的,这对高并发非常有效.可是我们还有其它一些常用需求,比如和操作系统 shell 命令交互,调用可执行文件,创建子进程进行阻塞式访问或高 CPU 计算等,child-process 就是为满足这些需求而生的.child-process 顾名思义,就是把 node 阻塞的工作交给子进程去做.

22. 创建子进程的方法有哪些,简单说一下它们的区别

创建子进程的方法大致有:

  1. spawn(): 启动一个子进程来执行命令
  2. exec(): 启动一个子进程来执行命令,与 spawn()不同的是其接口不同,它有一个回调函数获知子进程的状况
  3. execFlie(): 启动一个子进程来执行可执行文件
  4. fork(): 与 spawn()类似,不同电在于它创建 Node 子进程需要执行 js 文件
  5. spawn()与 exec()、execFile()不同的是,后两者创建时可以指定 timeout 属性设置超时时间,一旦创建的进程超过设定的时间就会被杀死
  6. exec()与 execFile()不同的是,exec()适合执行已有命令,execFile()适合执行文件。

(exec 可以用操作系统原生的方式执行各种命令,如管道 cat ab.txt | grep hello; execFile 是执行一个文件; spawn 是流式和操作系统进行交互; fork 是两个 node 程序(javascript)之间时行交互.)

23. 怎样充分利用多个 CPU?

一个 CPU 运行一个 node 实例。 (Child_Process)

24. 有哪些方法可以让 node 程序遇到错误后自动重启?

Linxu: 1) runit 2) forever 3) nohup npm start &
Winwow: Windows service(auto restart)

25. 关于 Express 框架

25.1. express 生成器的作用是什么?

通过应用生成器工具 express-generator 可以快速创建一个应用的框架, 包含一整套配置好的服务器配置, 文件和文件夹等, 包括静态资源的暴露等, 包括路由的配置, 和模板引擎配置, 以及 404 的处理,异常处理等;

25.2. express 优点是什么?

Express 的优点是线性逻辑:路由和中间件完美融合,通过中间件形式把业务逻辑细分,简化,一个请求进来经过一系列中间件处理后再响应给用户,再复杂的业务也是线性了,清晰明了。

25.3. 什么是中间件

  • 中间件是可以访问请求对象,响应对象以及 next 应用程序请求-响应周期中的函数,使用 app.use()来使用/定义中间件;
  • Express 是一个自身功能极简,完全是路由和中间件构成一个 web 开发框架;
  • 从本质上来说,一个 Express 应用就是在调用各种中间件。封装了一些或许复杂但肯定是通用的功能, 非内置的中间件需要通过安装后,require 到文件就可以运行。

25.4. express 缺点是什么?

Express 是基于 callback 来组合业务逻辑。Callback 有两大硬伤,一是不可组合,二是异常不可捕获

25.5. ejs 作用是什么?

EJS 是一个 Javascript 模板库, 用来从 JSON 数据中生成 HTML 文件。其他模板库(模板引擎如 jade/pug);

25.6. 什么是后端渲染项目?

浏览器请求静态网页资源, 服务器端会在后端把数据渲染到 HTML 页面上, 再把 html 文件内的字符串一起返回给浏览器进行展示的一种手段, Nodejs 中体现为 ejs 和 pug 模板引擎;

session 是区别于数据库存在的一种服务器临时存储技术, 它主要存储一些无需持久化的数据, 比如临时的登录状态信息等

cookie 是存在于浏览器上的一种浏览器本地存储的方式, 同域名下的 cookie 不同标签页可以共享, 默认过期时间是浏览器关闭时, 而且在进行 http 请求时, 会自动带上浏览器全部的 cookie 发给后台, 后台也可以获取 cookie, 设置可以在响应时, 想浏览器中设置 cookie。

25.8. 跨域(CORS)是什么, 如何解决跨域?

当 ajax 请求所在域名或接口和请求目标 url 的域名或接口, 有一个不同, 即发生了跨域请求, 浏览器会阻止这次 ajax 请求.

解决跨域请求的方法:

  1. 让后台(API)开启跨域支持;
  2. 通过iframe
  3. 使用 jsonp 方式处理跨域(需要服务器端支持);
  4. 反向代理(API Gateway),UI/API 配置到同一个API Gateway,浏览器端看到的结果就是在同一个域了;
  5. UI有编程能力(node.js/ asp.net)的话,可以代理其他站点的API

25.9. express4 中 app 和 router 的区别

app 可以认为是全局的,方便注入中间件;router 主要针对具体的 routing,除了注入中间件,具体处理 routing 对应的核心业务逻辑;
app 级路由不方便模块化封装,而且 app.js 文件没有路由代码,路由代码在 router 文件中,而且 router 方便模块化封装

25.10. Cookies 如何防范 XSS 攻击?

XSS(Cross-Site Scripting,跨站脚本攻击)是指攻击者在返回的 HTML 中插入 JavaScript 脚本。为了减轻这些攻击,需要在 HTTP 头部配置 set-cookie:

  • HttpOnly - 这个属性可以防止 cross-site scripting,因为它会禁止 Javascript 脚本访问 cookie。

  • secure - 这个属性告诉浏览器仅在请求为 HTTPS 时发送 cookie。

结果应该是这样的: Set-Cookie: sid=; HttpOnly. 使用 Express 的话,cookie-session 默认配置好了。

25.11. Koa 和 Express 的对比

  1. Express 是一个完整的 nodejs 应用框架。Koa 是由 Express 团队开发的,但是它有不同的关注点。Koa 致力于核心中间件功能。nodejs 中间件是访问请求对象(req)和响应对象(res)的例程。 Express 包含一个完整的应用程序框架,具有路由和模板等功能。
  2. Koa 对 Express 进行了扩展,并充分利用了 ES7 新的语法。Koa 的 Context 对象是对 Express 核心请求和应答对象的扩展,另外利用 async/await 来消除回调(callback)陷阱。
  3. Koa 的中间件的设计是洋葱模型。
  4. Koa 不是立即响应,是整个中间件处理完成在最外层进行了响应,而 Express 则是立即响应

26. KOA

26.1. KOA 洋葱模型

中间件执行就像洋葱一样,最早 use 的中间件,就放在最外层。处理顺序从左到右,左边接收一个 request,右边输出返回 response。
一般的中间件都会执行两次,调用 next 之前为第一次,调用 next 时把控制传递给下游的下一个中间件。当下游不再有中间件或者没有执行 next 函数时,就将依次恢复上游中间件的行为,让上游中间件执行 next 之后的代码。


—————- END —————-

0%